
时间:2026-01-20 10:18
人气:
作者:admin
在过去一年里,RAG(Retrieval-Augmented Generation)几乎成了企业落地大模型的标准配置。
原因很简单:
但当你真的把 RAG 从 Demo 推到生产,会发现三个问题几乎一定会出现:
这篇文章不会再重复“RAG 是什么”这种内容,而是围绕一个真实企业级目标展开:
在 10 万级文档规模下,如何构建一个可用、稳定、可扩展的 RAG 系统。
RAG 的本质不是“问答”,而是信息检索系统
很多人理解 RAG 是:
向量检索 + 大模型生成
但在工程视角下,它更像一个搜索系统:
如果你做过搜索或推荐系统,会发现很多问题是相通的。

根本原因通常不是模型,而是三点:
在 10 万文档规模下,实际进入向量库的 chunk 往往是 50 万~300 万级别。
如果你:
那检索慢几乎是必然的。
这是企业 RAG 最常见、也是最隐蔽的问题。
核心原因通常有四类:
很多团队第一版 RAG 的失败,并不是模型不行,而是检索层根本没把信息找对。
因为 RAG 是一个系统工程:
如果每一层都是“随便拼的”,后期几乎无法维护。
下面进入真正的实战部分,我会按照真实项目的构建顺序展开。
文档清洗的三个工程原则
建议在入库前至少做:
常见误区是:
chunk 越小,检索越准
在企业语料中,这往往是错的。
推荐经验区间:
示例(伪代码):
chunks = semantic_split(
    text,
    max_tokens=600,
    overlap=100
)
不要盲选“排行榜第一”的 embedding
企业级场景更看重:
实测经验:
如果你需要快速定制 embedding 模型,而不想从零写训练代码,可以考虑LLaMA-Factory Online用在线方式对 embedding 模型做领域适配,成本和风险都更可控。
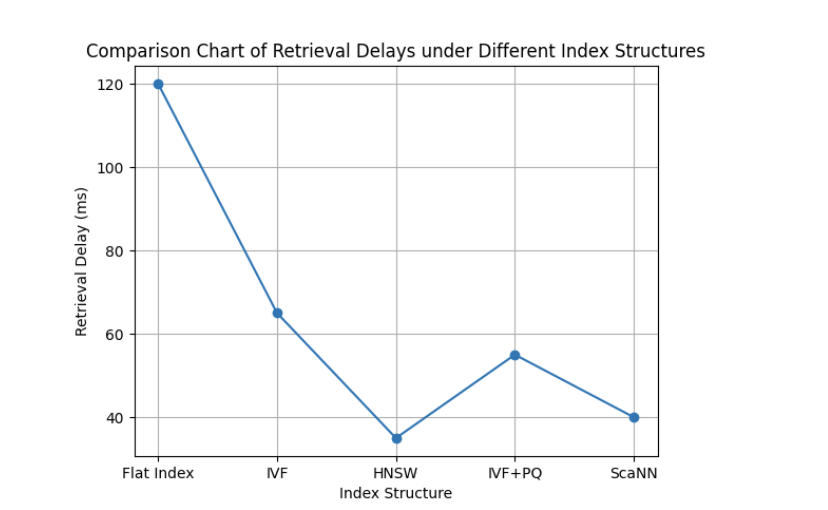
索引结构决定了 80% 的性能
在 10 万+ 文档规模下,强烈建议:
示例(FAISS):
index = faiss.index_factory(
    dim,
    "IVF4096,PQ64"
)
纯向量召回在企业场景一定不够。
推荐组合策略:
这样可以显著减少“明明有却搜不到”的情况。
如果说 embedding 决定“找不找得到”,
那 rerank 决定“用不用得上”。
建议:
rerank 模型不需要很大,但一定要语义理解强。
企业级 RAG 中,生成阶段要注意三点:
示例 Prompt 思路:
你只能基于提供的资料回答问题。
如果资料中没有答案,请明确说明“资料不足”。
必须量化的四个指标

从真实业务中抽取:
做成固定评测集,每次改动都跑一遍。
当你真的把 RAG 做到企业级,会发现一个结论:
RAG 的上限,取决于你对“检索系统”的理解,而不是模型参数量。
未来 1~2 年,我认为企业级 RAG 会呈现三个趋势:
如果你正在做 RAG 的工程落地,建议尽早把模型训练、评估、部署流程标准化。
像LLaMA-Factory Online这类工具,本质价值并不是“省几行代码”,而是降低试错成本,让工程团队把精力放在真正重要的地方。
如果你愿意,下一篇我可以继续深入:
“RAG + 微调到底怎么选?哪些场景 RAG 一定不够?”

 关注微信