
时间:2026-01-21 12:14
人气:
作者:admin
如果你已经看过一些 PPO 的原理文章,大概率会有过这种感觉:
好像每个字都认识,但真让我自己写代码,脑子还是一片空白。
这其实挺正常的。
至少我第一次准备动手写 PPO 的时候,也是这种状态。
问题不在你,而在 PPO 本身。
在论文里,PPO 看起来是一个干净利落的算法;
但一旦落到工程里,它立刻变成了一整条系统链路:
任何一个地方写错,都不一定会立刻报错,但后果可能很严重:
所以这篇文章我只想做一件事:
不用任何黑盒框架,从零用 PyTorch 跑通一版不容易翻车的 PPO 微调。
它不追求最优,也不炫技。
目标只有一个:工程上尽量安全。
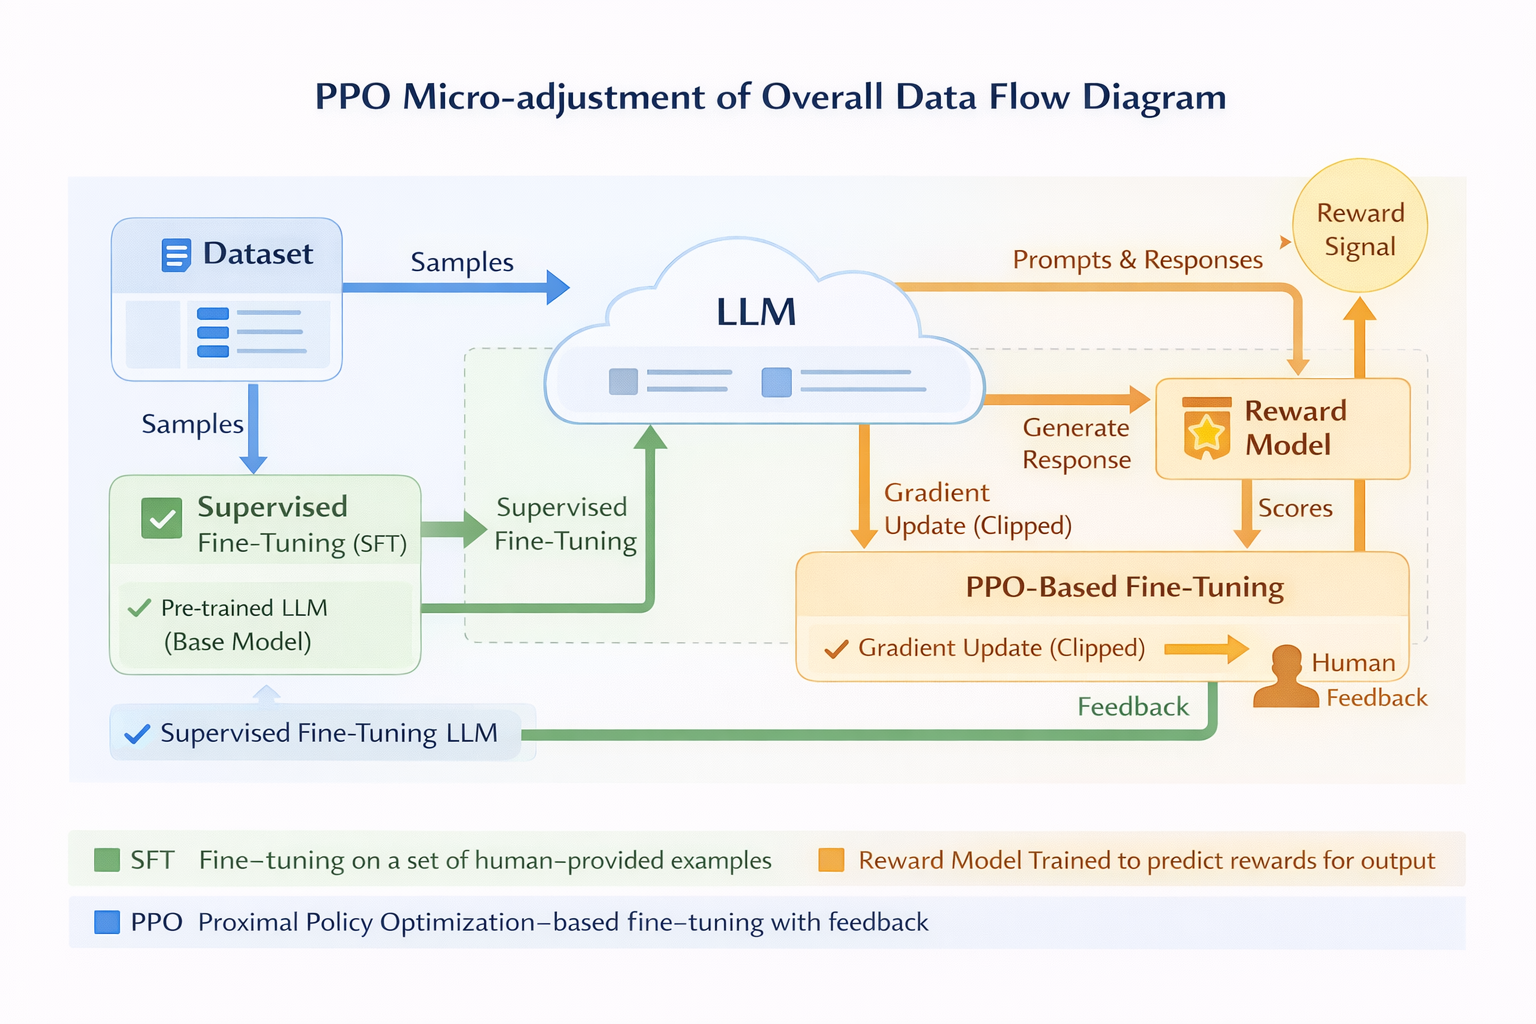
PPO 微调整体数据流图
在真正写 PPO 代码之前,我建议你先确认三件事。
第一,你的 base model 已经做过 SFT
PPO 并不是用来教模型“怎么回答问题”的,它更像是在微调模型的行为边界。
第二,你手里有一个能打分的 Reward Model
它不需要特别聪明,只要稳定、一致、别太极端,就已经够用了。
第三,也是最重要的一点
你得接受一个现实:
第一版 PPO 的目标不是效果炸裂,而是模型没被你训坏。
很多失败的 PPO 项目,问题并不出在算法上,而是工程师一开始就太着急,想“一步调到最优”。
在写任何代码之前,先在脑子里有一张全局图,会让你少踩很多坑。
在大模型场景下,一次完整的 PPO iteration,通常包括这些步骤:
如果一定要打个比方,我更愿意这样理解 PPO:
它就像给策略梯度拴了一根安全绳。
你可以往上爬,但不允许一步跨得太狠。
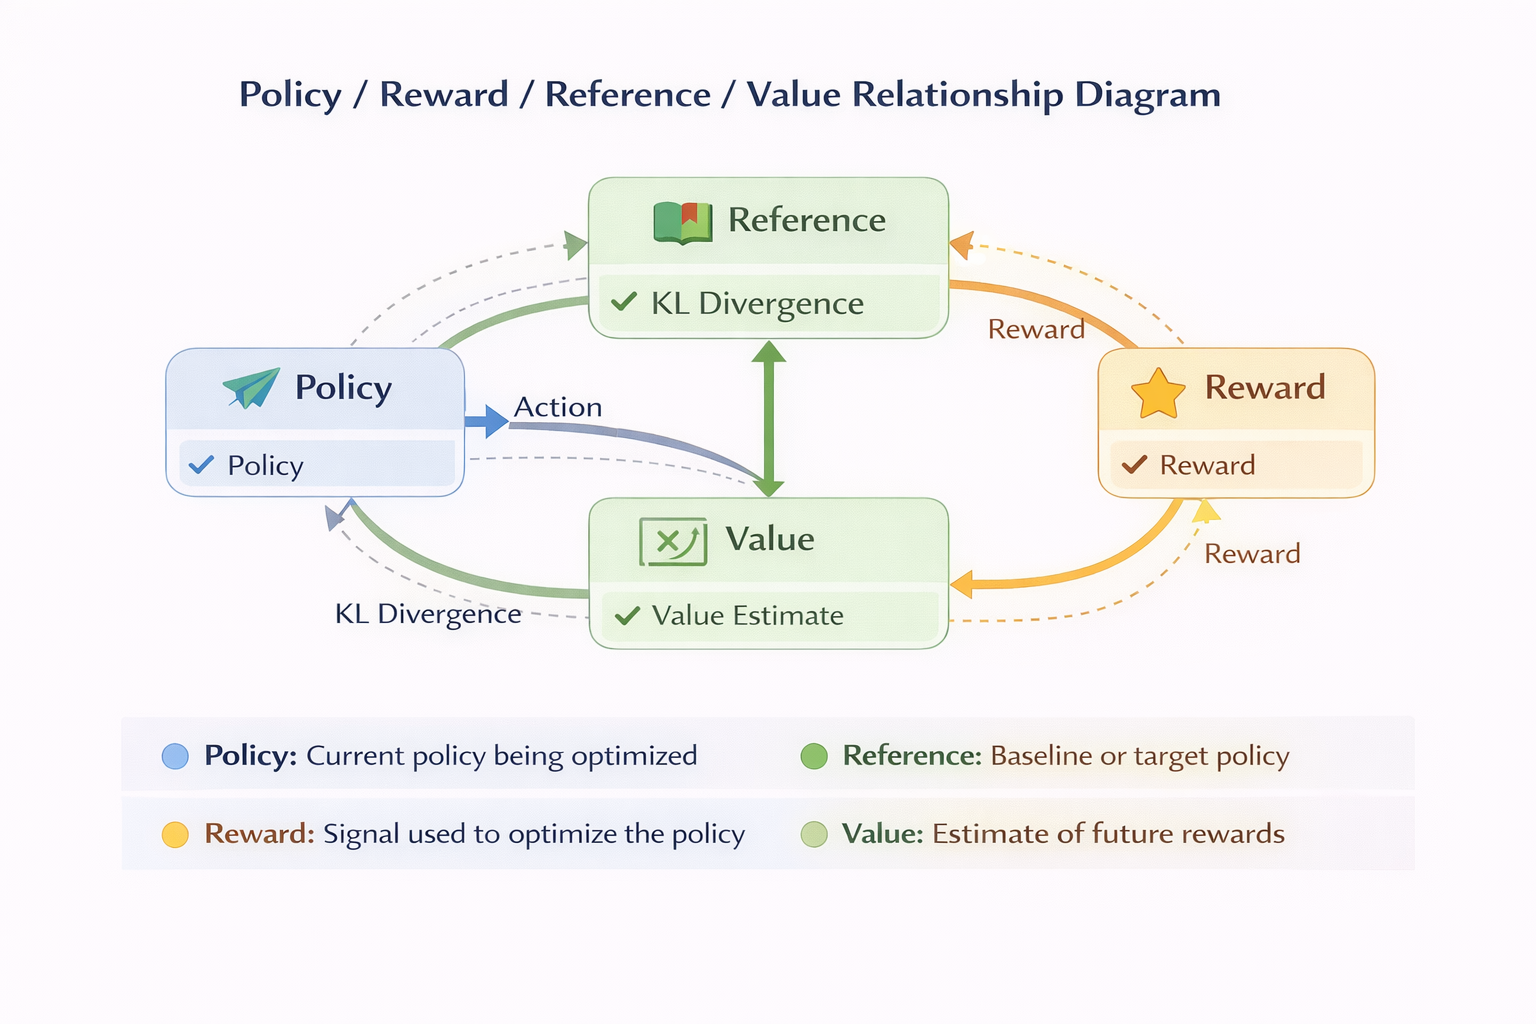
Policy / Reward / Reference / Value 关系图
from transformers import AutoModelForCausalLM, AutoTokenizer

model = AutoModelForCausalLM.from_pretrained("your_sft_model")
ref_model = AutoModelForCausalLM.from_pretrained("your_sft_model")
tokenizer = AutoTokenizer.from_pretrained("your_sft_model")

ref_model.eval()
for p in ref_model.parameters():
    p.requires_grad = False
这里有一个我必须强调的工程原则:
reference model 是 PPO 的“底线”。
没有 ref model,你会遇到很多非常隐蔽的问题:
说实话,我见过的不少 PPO 事故,追根溯源,几乎都能回到这一点:
ref model 被弱化了,甚至被“顺手一起训了”。
和 supervised learning 不一样,PPO 的训练样本并不是现成的数据集,而是模型自己生成的。
def generate_response(model, prompt_ids, max_new_tokens=128):
    with torch.no_grad():
        output = model.generate(
            input_ids=prompt_ids,
            max_new_tokens=max_new_tokens,
            do_sample=True,
            top_p=0.9,
            temperature=1.0
        )
    return output
这里有几个非常现实、但经常被忽略的点:
如果是第一次跑 PPO,我的建议很保守:
很多人一上来就会纠结:
Reward Model 一定要非常准吧?
但在 PPO 里,一个更现实的结论是:
reward 的排序性,远比绝对值重要。
工程上我更关心的是:
KL penalty 在 PPO 中真的不是装饰品。
它更像是一根保险丝,用来防止模型在 reward 的驱动下“性格突变”。
def compute_kl(logits, ref_logits):
    log_probs = torch.log_softmax(logits, dim=-1)
    ref_log_probs = torch.log_softmax(ref_logits, dim=-1)
    kl = torch.sum(
        torch.exp(log_probs) * (log_probs - ref_log_probs),
        dim=-1
    )
    return kl.mean()
几个很实在的工程经验:
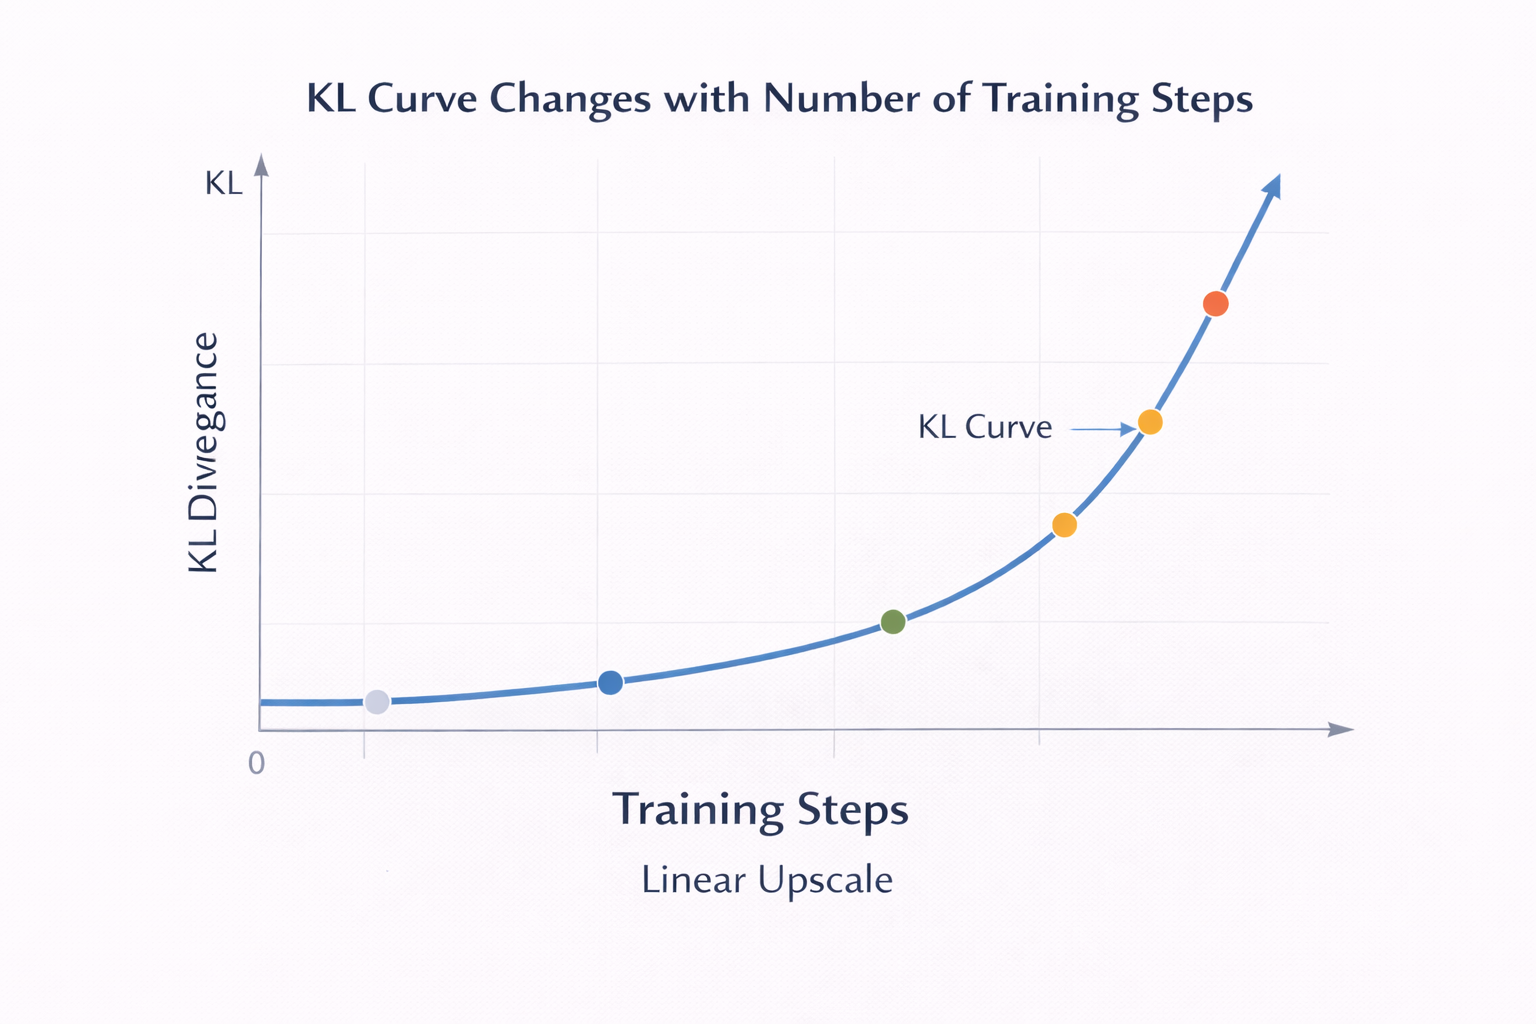
KL 曲线随训练步数变化
在 PPO 里,reward 更像“结果”,而 advantage 更像“方向”。
最简单、但在工程上能用的 advantage 写法是:
advantage = total_reward - total_reward.mean()
它看起来确实有点粗糙,但解决了一个很关键的问题:
这里有个重要认知:
第一版 PPO,真的不需要一个很完美的 value model。
ratio = torch.exp(new_logprob - old_logprob)

clipped_ratio = torch.clamp(ratio, 1-eps, 1+eps)

loss = -torch.mean(
    torch.min(ratio * advantage, clipped_ratio * advantage)
)
在工程里你一定要知道:
真正有价值的信号,其实是:
for batch in prompts:
    response = generate_response(model, batch)

    reward = reward_model(response)
    kl = compute_kl(
        model_logits(response),
        ref_model_logits(response)
    )

    total_reward = reward - beta * kl
    advantage = total_reward - total_reward.mean()

    for _ in range(ppo_epochs):
        loss = ppo_loss(...)
        loss.backward()
        optimizer.step()
        optimizer.zero_grad()
一些很“工程”的建议:
如果你不想一开始就手写所有 PPO 细节,LLaMA-Factory online 已经把 PPO + KL + Reward 的完整流程封装好,用它先跑一条“参考答案”,再回头对照自己的 PyTorch 实现,会省很多时间。
真正成熟的 PPO 训练,看的从来不只是一个 loss。
至少要包括这些:
如果只能选一个重点盯:
盯 KL。
当你已经能稳定跑通 PPO 之后,可以再考虑这些事情:
顺序真的很重要:
永远先稳,再谈强。
如果只总结三点经验,那会是这样:
第一,PPO 的核心不是把 reward 拉到多高,而是控制变化幅度
第二,KL 是 PPO 的灵魂,而不是可选项
第三,一版 PPO 是否成功,最现实的标准只有一个:
模型还像不像一个正常模型
在真实工程里,很多团队都会选择这样的路径:
先用 LLaMA-Factory online 跑通一版稳定的 PPO,对齐整体流程,再把关键模块逐步迁移到自研的 PyTorch 实现中。这条路不一定最优,但通常最稳。

 关注微信