时间:2025-11-25 09:55
人气:
作者:admin
近年来,大型语言模型(LM)Agent在自动化软件工程(Software Engineering, SE)任务方面取得了显著进展。然而,在能力飞速提升的背后,开源社区与掌握海量私有数据的专有模型之间正形成一道日益扩大的鸿沟。其核心症结在于:高质量、大规模训练数据的严重稀缺已成为制约开源模型发展的根本瓶颈。为了确保开放研究在这一关键领域保持竞争力,我们必须建立一种能够 democratize(大众化)数据生产的基础设施。
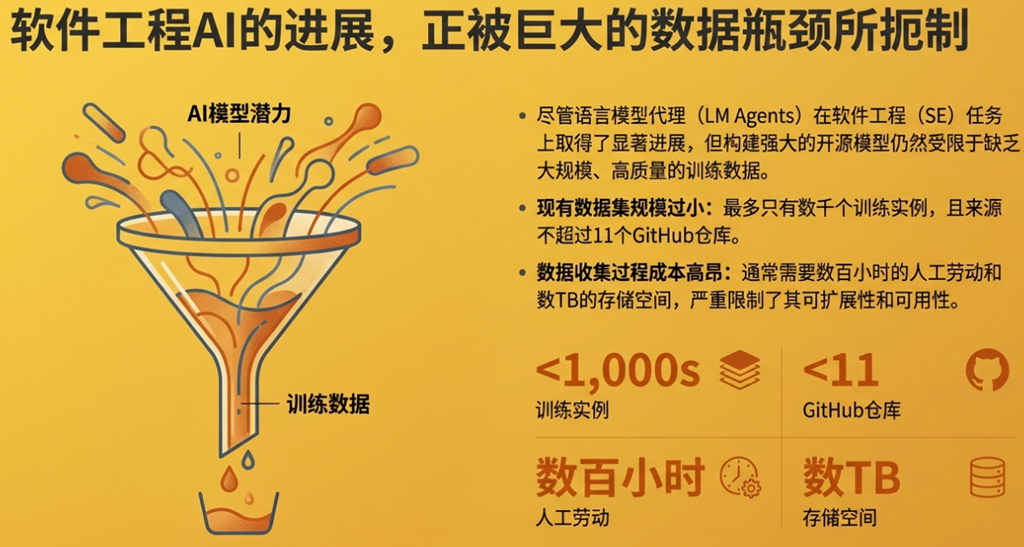
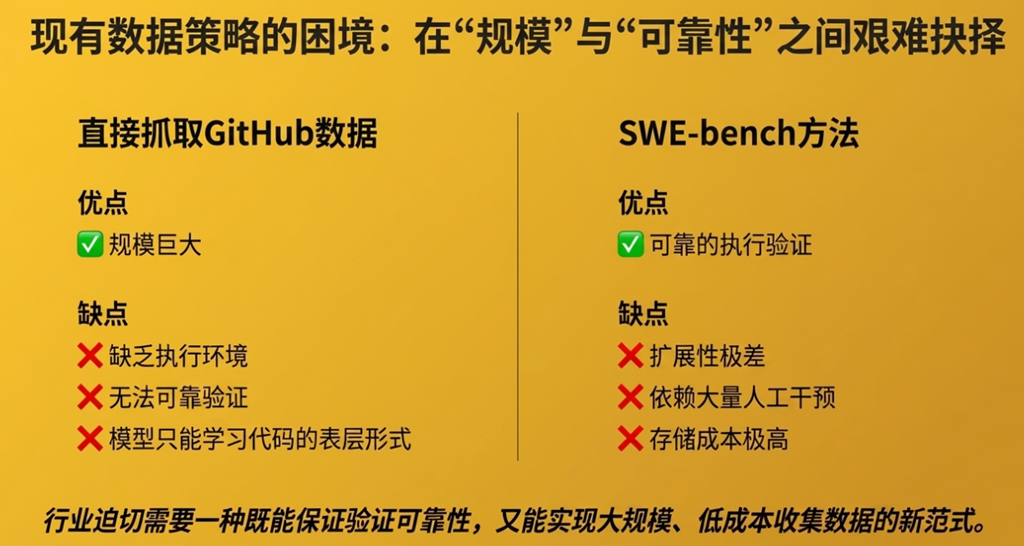
当前的数据收集方法在可扩展性上存在显著局限。以权威基准测试SWE-bench为例,虽然其提供的数据质量极高,但其生成过程却难以规模化。这些数据集的实例规模最多仅为数千个,且通常来源于十余个代码库,策展过程需要数百小时的人力投入,并且其配套的执行环境占用了数TB的存储空间。这些高昂的成本使得遵循其模式来创建大规模训练集变得不切实际。另一方面,直接从GitHub抓取数据虽能获得海量实例,但这些数据缺乏执行环境和可靠的测试验证,导致模型无法进行真正基于执行结果的深度学习。
为了突破这一困境,我们引入了SWE-smith——一个旨在从根本上解决数据瓶颈的创新性解决方案。SWE-smith提出了一套全新的、可扩展的流程,能够为任意Python代码库自动合成成千上万个高质量的训练任务实例。将深入探讨SWE-smith的架构、核心方法论及其对软件工程AI领域的深远影响。为了真正释放开源软件工程代理的潜力,我们必须采用一种全新的、可扩展的数据生成范式,而SWE-smith正是这一范式的具体实现。
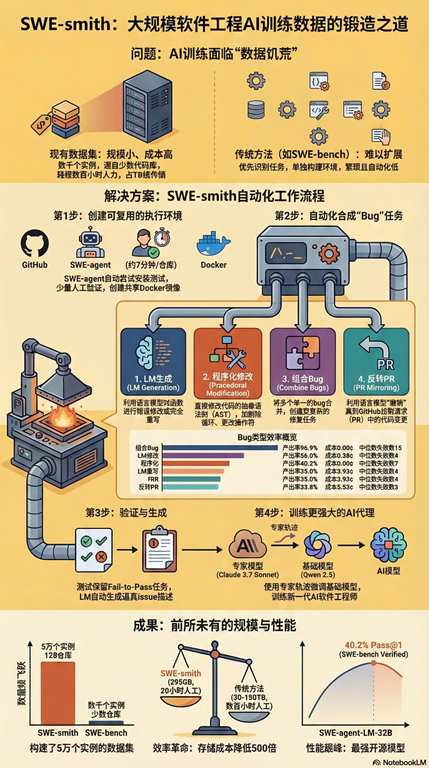
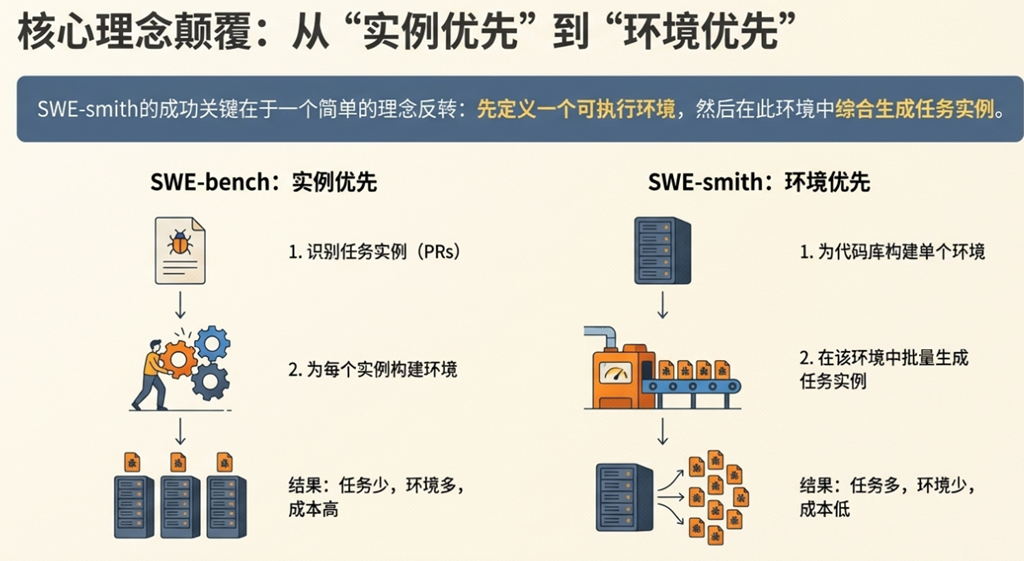
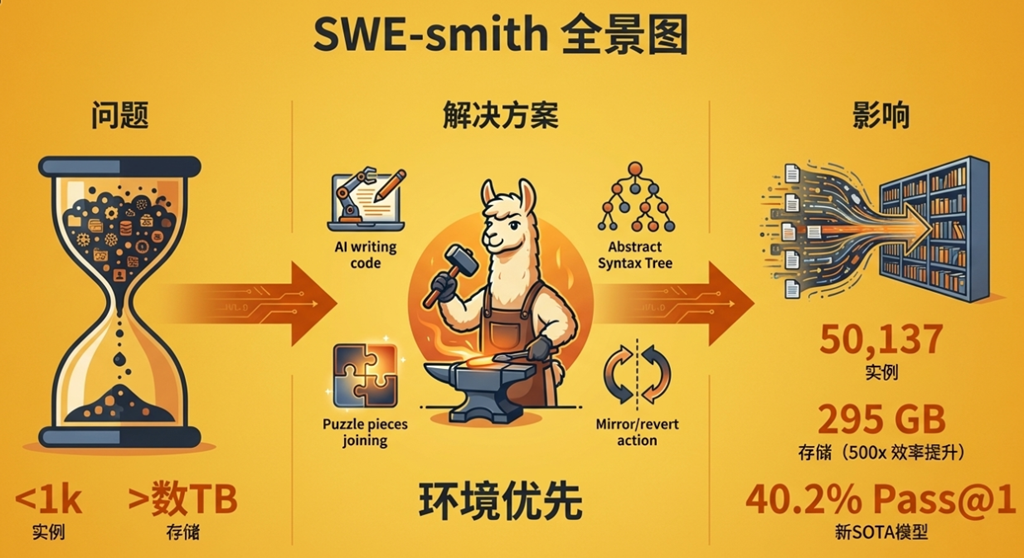
SWE-smith的核心思想是通过颠覆传统的数据收集流程来实现大规模扩展。它将数据生成过程从“先找任务,后配环境”逆转为“先建环境,后造任务”,从而在效率、成本和规模上实现了数量级的突破。
核心理念对比
为了更清晰地理解这一范式转移,下表对比了传统方法与SWE-smith的根本差异:
SWE-bench 传统方法 | SWE-smith 创新范式 |
任务优先,环境在后 | 环境优先,任务在后 |
首先从GitHub的拉取请求(PRs)中筛选出符合条件的任务实例,然后为每一个独立的任务实例构建其特定的历史版本执行环境。这一流程导致每个任务都需要一个独立的Docker镜像,造成了巨大的存储开销和人力成本,难以扩展。 | 首先为整个代码库的最新版本构建一个统一、稳定、可共享的执行环境(Docker镜像)。然后,在这个标准化的环境中,通过自动化技术合成成百上千个任务实例。这一流程从根本上解决了存储和人力瓶颈。 |
工作流程图解
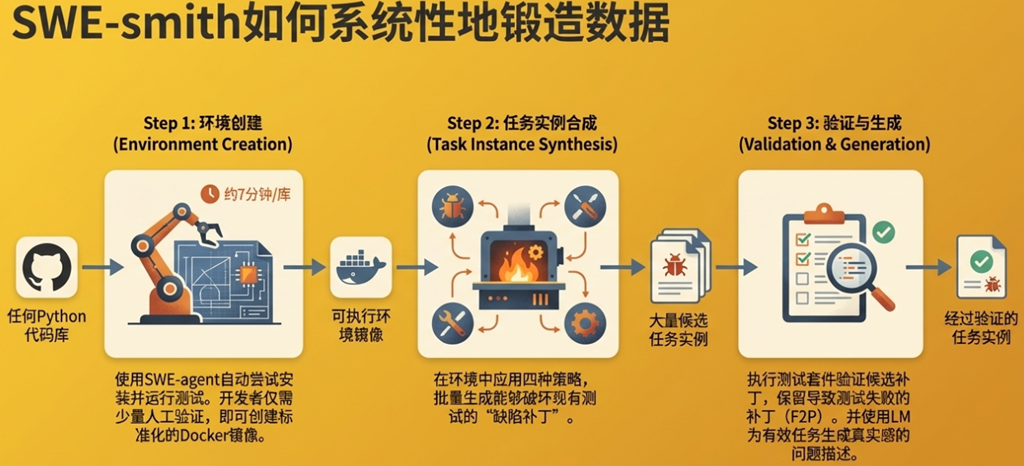
SWE-smith通过一个高度自动化的流水线,将一个GitHub代码库转化为海量的训练数据。其完整工作流程可分为以下五个关键步骤:
1. 环境构建: 首先,系统接收一个GitHub代码库。利用SWE-agent这一自动化代理,系统在100步内自动尝试安装代码库依赖并运行其测试套件。随后,仅需开发者进行约7分钟的轻量级人工核实,确认安装与测试指令无误后,即可创建一个标准化的、可供后续所有任务共享的Docker镜像环境。
2. 任务合成: 在构建好的统一环境中,SWE-smith运用多种“故障注入”策略,向代码库中引入潜在的错误。这些策略包括利用LM生成修改、进行程序化的代码修改等,从而创造出大量能够导致现有测试失败的任务实例候选项。
3. 验证与筛选: 系统对每一个任务候选项应用补丁,并运行完整的测试套件。只有那些能够稳定复现“失败-通过”(Fail-to-Pass, F2P)测试场景的候选项——即导致至少一个原本通过的测试变为失败——才会被筛选保留,成为一个有效的任务实例。
4. 问题陈述生成: 对于每一个通过验证的有效任务,系统利用LM自动生成一个逼真的、模拟真实GitHub Issue风格的问题描述。这使得合成的任务在形式上与真实世界的软件工程挑战高度一致。
5. 训练数据生成: 最后,使用一个专家模型(如Claude 3.7 Sonnet)在SWE-agent系统中解决这些合成的任务。系统会记录下专家模型解决问题的完整操作序列,即“专家轨迹”(expert trajectories),这些轨迹最终构成了用于微调学生模型的高质量训练数据。
通过这一范式的转变,SWE-smith为其在数据生成规模、成本控制和执行效率上的巨大优势奠定了坚实的基础。接下来,我们将深入剖析其各个核心技术组件。
Docker镜像
docker pull registry.cn-hangzhou.aliyuncs.com/megadotnet/jyangballin.swesmith.x86_64 && docker tag registry.cn-hangzhou.aliyuncs.com/megadotnet/jyangballin.swesmith.x86_64 jyangballin/swesmith.x86_64
本章节将逐一剖析SWE-smith流水线的关键技术环节,从可扩展环境的创建到多样化任务的合成,再到最终训练数据的生成,详细阐述其实现细节与设计考量。
3.1. 环境构建:奠定可扩展性的基石
SWE-smith的可扩展性始于其创新的环境构建流程。该流程的核心是**“一次构建,处处复用”**。
具体而言,对于一个给定的GitHub代码库,系统首先利用SWE-agent代理,在不超过100个操作步骤的限制内,自动探索并执行安装依赖和运行测试套件所需的一系列指令。这个自动化过程极大地减少了人工介入的需要。
随后,开发者仅需进行一个极其轻量化的验证环节。通过检查SWE-agent的执行轨迹,开发者花费大约7分钟即可核实正确的安装与测试指令。确认无误后,一个包含完整开发环境和测试套件的标准化Docker镜像便被创建出来。这一模式的战略价值在于,它彻底摒弃了传统方法中为每个任务实例创建独立环境的低效做法。通过为每个代码库创建一个统一的、共享的执行环境,SWE-smith不仅将人力成本降至最低,更关键的是,它极大地压缩了存储开销,为后续生成成千上万个任务实例铺平了道路。
3.2. 任务实例合成:多样化的“故障注入”策略
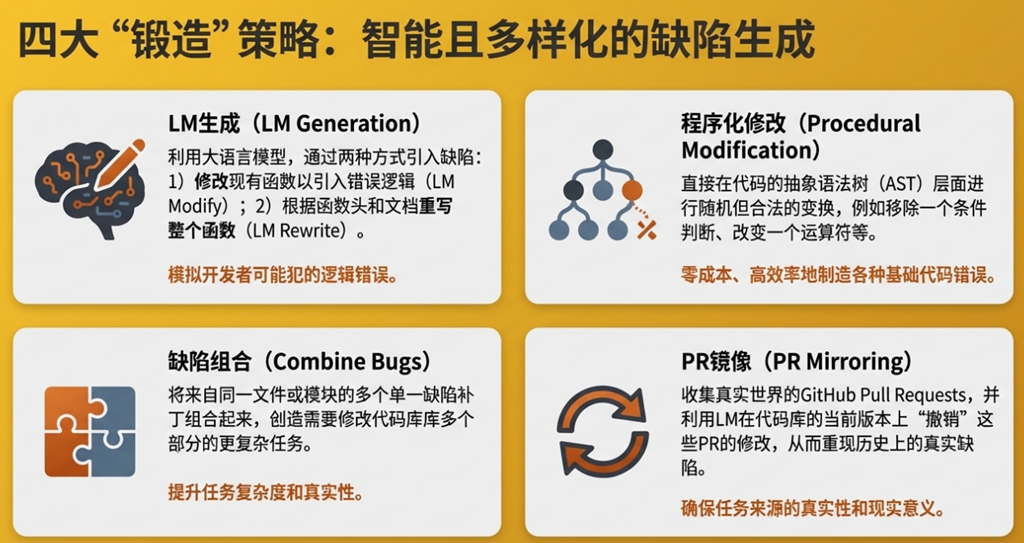
在统一的环境中,SWE-smith采用四种互补的核心策略来自动合成任务实例,即向健康的代码库中“注入故障”。这些策略确保了生成任务的多样性和真实性。
LM生成 (LM Generation)
该策略利用大型语言模型(LM)的编程能力来创造微妙且符合逻辑的错误。
• LM修改 (LM Modify): 向LM提供一个代码库中现有的函数,并明确提示其引入一个会导致逻辑错误的细微修改。例如,改变计算顺序、错误处理边界条件或调整循环判断符。
• LM重写 (LM Rewrite): 仅向LM提供函数的头部定义(签名)和文档字符串(docstring),要求其从零开始重新实现该函数。在这个过程中,LM可能会自然地引入与原始实现不完全一致的逻辑,从而产生潜在的错误。
程序化修改 (Procedural Modification)
这是一种完全自动化且零成本的故障注入方法,通过直接操作代码的抽象语法树(Abstract Syntax Tree, AST)来引入错误。这种方法可以精确地进行多种可控的转换,具体示例包括:
• 移除一个if条件判断或一个for/while循环。
• 将一个二元运算符(如 +)更改为另一个(如 -)。
• 交换if/else语句块中的执行逻辑。
• 移除一个变量赋值语句等十余种转换。
组合故障 (Combine Bugs)
该策略旨在创建更复杂的任务,这些任务通常需要编辑代码库的多个部分才能解决。它通过聚合来自同一文件或同一模块的多个单一故障候选项来实现。例如,将两个独立的、由LM生成或程序化修改产生的函数级错误组合成一个单一的、更具挑战性的任务实例。
反转PR (Invert PRs / PR Mirror)
此策略旨在模拟真实世界中的软件回归问题,即过去修复的漏洞再次出现。其工作原理如下:
1. 系统向LM提供一个已经合并到代码库中的拉取请求(PR)的代码变更(.diff文件)。
2. LM的任务是在代码库的当前最新版本中,智能地“撤销”这些变更,相当于将修复补丁反向应用。
值得强调的是,与SWE-bench检出旧版commit的做法不同,SWE-smith的“PR镜像”策略始终在统一的、最新的执行环境中操作。这确保了所有合成的任务都与标准化的Docker环境完全兼容,从而维持了整个流程的可扩展性。
3.3. 基于执行的验证:确保任务的有效性
任务合成仅仅是第一步,确保这些合成的“故障”是有效且可复现的至关重要。为此,SWE-smith引入了严格的基于执行的验证流程。
对于每一个由上述策略生成的候选补丁,系统会自动将其应用到代码库中,并运行完整的测试套件。只有满足以下条件的补丁才会被保留为有效的任务实例:
• 必须导致至少一个原本能够通过的测试失败。 这种“通过到失败”(Pass-to-Fail)的转变被记录为“Fail-to-Pass”(F2P)测试。
这个验证步骤确保了每个生成的任务都有一个明确、可衡量的“失败”状态,为后续AI代理的解决过程提供了清晰的目标。为了保证整个数据生成流水线的高效运转,单个测试套件的执行时长被限制在两分钟以内,超时将被视为无效候选项。
3.4. 问题陈述生成:模拟真实世界场景
一个高质量的训练实例不仅需要可执行的代码故障,还需要一个模拟真实场景的问题描述。SWE-smith通过一个巧妙的LM调用流程,为每个合成的故障自动生成高质量、类似真人编写的GitHub Issue。
该流程向LM提供了三项关键输入信息:
1. 故障补丁(.diff): 描述了引入错误的代码变更。
2. 一个随机F2P测试的源代码: 提供了一个具体的失败场景。
3. 测试执行输出: 应用故障补丁后,运行测试时产生的错误日志和堆栈跟踪。
基于这些信息,LM被要求生成一份包含复现代码的、风格自然的GitHub Issue文本。这使得训练数据不仅在技术上有效,在交互形式上也高度逼近软件工程师在实际工作中遇到的场景。
以上四个环节构成了一个高效、自动化的数据生产线。这条生产线所产出的数据在规模、效率和最终应用效果上均取得了卓越的成果,我们将在下一章节中详细展示。
SWE-smith不仅是一个理论框架,更是一个经过实践验证、成果斐然的工具包。本章将通过量化数据,展示其在数据集规模、资源效率以及对提升AI代理性能方面的巨大影响。
4.1. 数据集分析:规模与多样性的飞跃
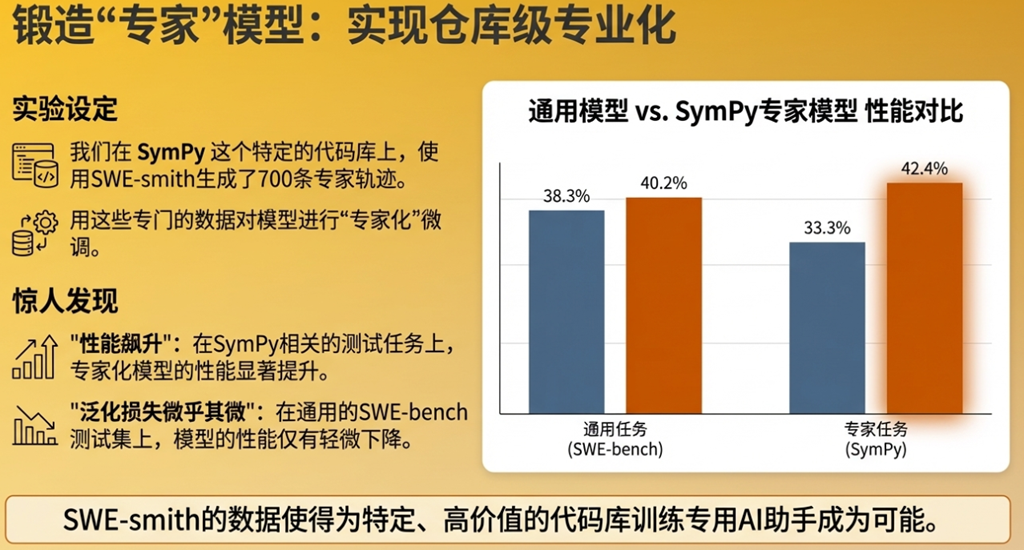
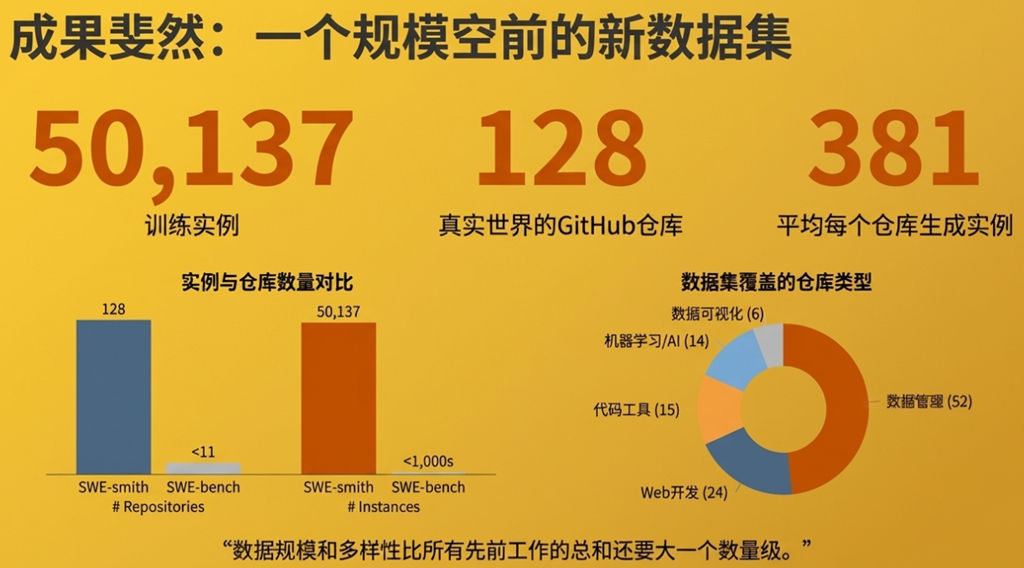
通过SWE-smith流程,我们创建了一个规模空前的软件工程训练数据集。其核心指标如下:
• 数据集规模: 包含 50,137个 任务实例。
• 代码库覆盖: 横跨 128个 真实的、多样化的GitHub代码库。
• 数量级优势: 其任务实例总数比所有先前相关工作的总和还要大一个数量级。
创建成本与效率
SWE-smith的效率同样令人瞩目。整个庞大数据集的创建仅耗费了约 20小时 的人工审核时间(主要用于验证环境安装指令)和 1360美元 的总计算成本。这证明了其作为一种大规模数据生产工具的经济可行性。
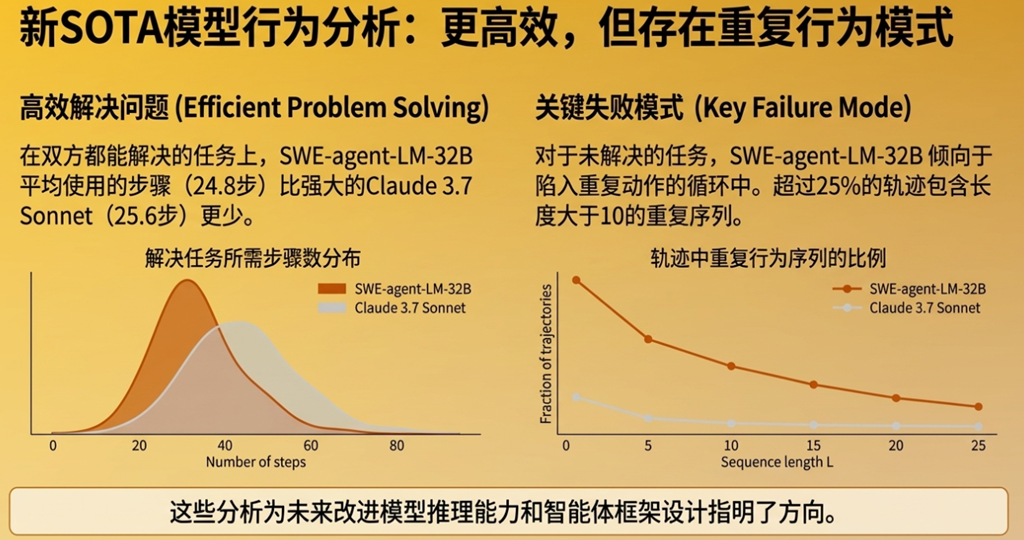
故障策略产出分析
不同的故障注入策略在产出率和任务特性上表现各异,下表总结了各项关键指标:
策略名称 | 产出率 (%) | 实例数 | F2P测试中位数 | 编辑行数中位数 |
组合故障 (Combine Bugs) | 96.9% | 10,092 | 15 | 11 |
LM修改 (LM Modify) | 56.0% | 17,887 | 4 | 3 |
程序化修改 (Procedural Modification) | 40.2% | 15,641 | 7 | 5 |
LM重写 (LM Rewrite) | 35.0% | 4,173 | 4 | 24 |
PR镜像 (PR Mirror) | 33.8% | 2,344 | 3 | 14 |
总计 | 50.1% | 50,137 | 6 | 5 |
从表中可以观察到,“组合故障”策略的产出率最高,因为它聚合了已经验证过的单一故障。而“PR镜像”和“LM重写”策略虽然产出率较低,但它们产生的任务在编辑行数上更多,通常也更接近真实世界软件开发的复杂性。
4.2. 与现有数据集的对比分析
下表将SWE-smith与其它主流的开源软件工程训练数据集进行了直观对比,凸显了其在多个维度上的领先地位。
数据集 | 任务数 | 代码库数 | 是否可执行 | 数据来源 | 环境大小 |
R2E | 0.25k | 137 | ✓ | 合成 | 270 GBs |
R2E-gym | 4.6k | 10 | ✓ | 合成 | 4 TBs |
SWE-bench-extra | 6.38k | 2k | 真实 | - | |
SWE-bench-train | 19k | 37 | 真实 | - | |
SWE-fixer | 115k | 856 | 真实 | - | |
SWE-gym | 2.4k | 11 | ✓ | 真实 | 6 TBs |
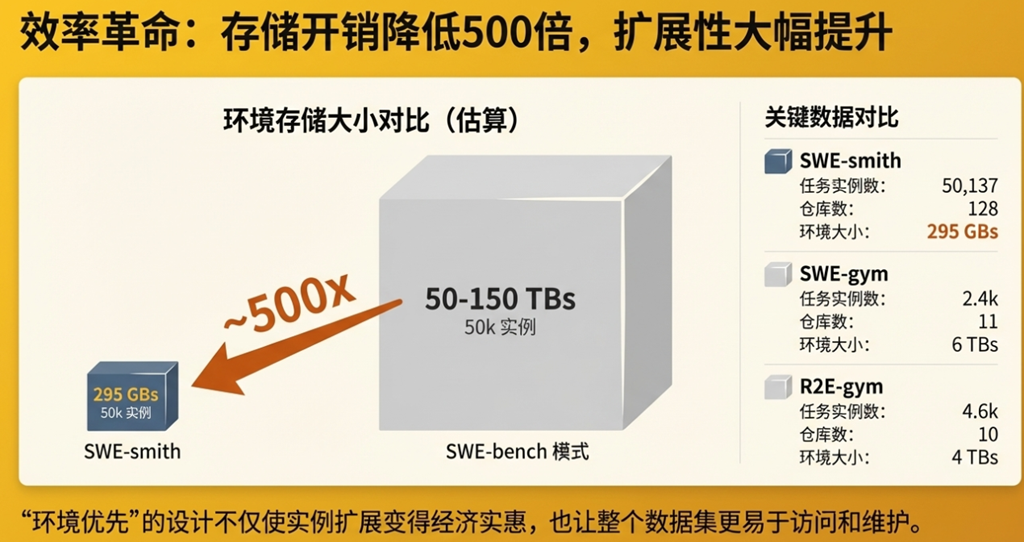
SWE-smith | 50k | 128 | ✓ | 两者皆有 | 295 GBs |
分析与解读
上表清晰地显示,SWE-smith在可执行任务实例的数量和覆盖的代码库广度上拥有绝对优势。更值得注意的是其在存储效率上实现的巨大突破。由于采用了“环境优先”的共享环境范式,SWE-smith为5万个任务实例构建的环境总大小仅为295GB。相比之下,若使用SWE-bench的“一任务一环境”方法创建同等规模的数据集,预计需要50到150TB的存储空间。这意味着SWE-smith的存储效率提升了约500倍。这一数量级的效率提升,直接解决了以往大规模可执行数据集对于学术界和独立研究者而言门槛过高的核心痛点。
4.3. SOTA模型训练成果:SWE-agent-LM-32B的卓越表现
SWE-smith数据集的最终价值体现在其训练AI代理的能力上。我们使用该数据集训练了SWE-agent-LM-32B模型,并取得了突破性成果。
训练过程
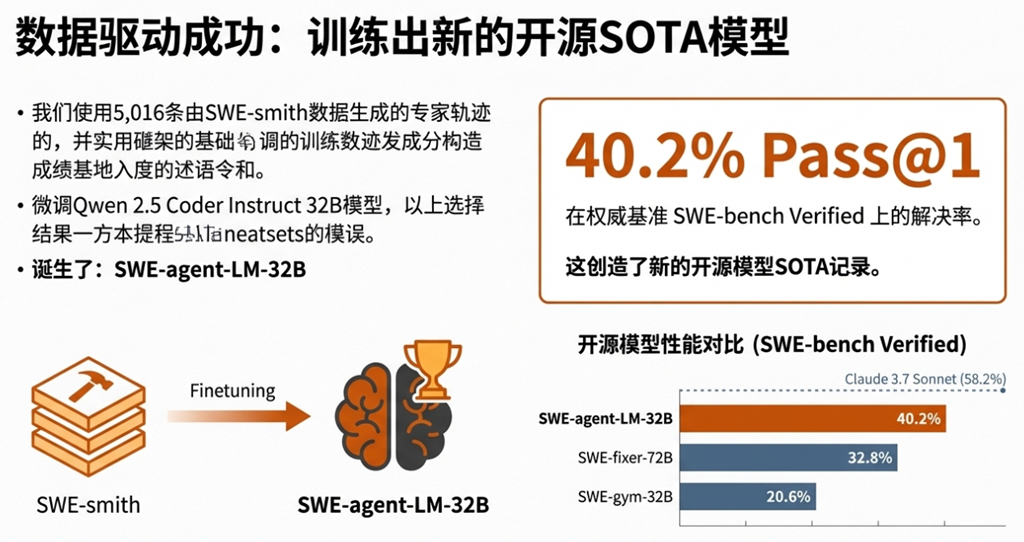
1. 专家轨迹生成: 我们使用强大的Claude 3.7 Sonnet模型作为“专家”,在SWE-smith生成的任务上运行SWE-agent系统,成功解决了5,016个任务,并记录下完整的解决轨迹。
2. 模型微调: 我们使用这5,016条高质量的专家轨迹,对Qwen 2.5 Coder Instruct 32B模型进行了微调,最终得到了SWE-agent-LM-32B。
性能突破
在权威的软件工程基准测试SWE-bench Verified(一个为确保可靠性而经过人工精选的子集)上,SWE-agent-LM-32B取得了40.2%的Pass@1解决率。这一成绩在当时创造了所有开源模型的新纪录,达到了业界领先水平(State of the Art, SOTA)。
数据量与性能关系
实验结果有力地证明了SWE-smith数据的有效性,并揭示了清晰的“缩放定律”(scaling law)。随着用于训练的专家轨迹数量从100条增加到5,000条,模型的解决率也从14.3%稳步提升至40.2%。这表明,SWE-smith不仅提供了大量的训练数据,而且这些数据的质量足以驱动模型性能的持续提升。
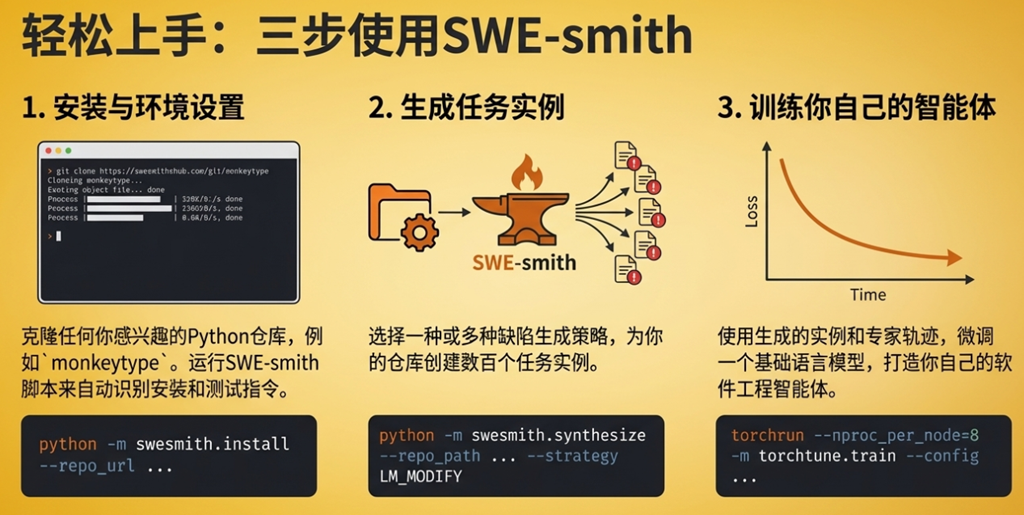
这些成果不仅验证了SWE-smith数据的质量和其方法论的成功,更揭示了一系列关于如何有效开发软件工程代理的深刻洞见,为我们下一章的深入探讨做好了铺垫。
SWE-smith的庞大数据集不仅是训练模型的“燃料”,更是一个独特的“实验室”。它使我们能够系统性地进行消融实验,研究和验证影响软件工程AI代理性能的多个关键因素,从而提炼出宝贵的洞见。
5.1. 训练数据源对模型性能的影响
通过对比使用不同来源的训练数据所产生的模型性能,我们得出了两个核心结论:
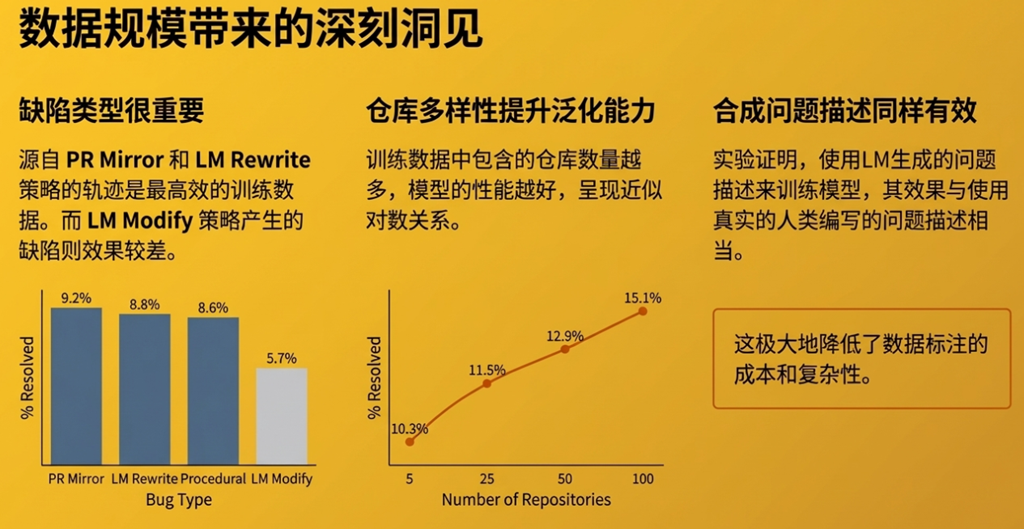
• 不同故障类型的效能差异: 实验表明,源自“反转PR”(PR Mirror)策略的专家轨迹在训练中最有效。这符合预期,因为该策略生成的任务最接近真实世界的软件开发和回归场景。同时,值得注意的是,由“LM重写”和“程序化修改”这两种纯合成策略生成的轨迹,也能训练出具有高度竞争力的模型。这有力地证明了合成数据在模拟真实任务、提升模型解决实际问题能力方面的巨大潜力。
• LM生成的问题陈述同样有效: 对比实验显示,使用LM自动生成的问题陈述来训练模型,其最终效果与使用从真实PR中提取的原始问题陈述相当。这一发现具有重大意义,因为它验证了问题陈述生成环节的自动化是完全可行的,从而极大地增强了整个数据生成流程的可扩展性和效率,摆脱了对真实问题文本的依赖。
5.2. 数据多样性的价值
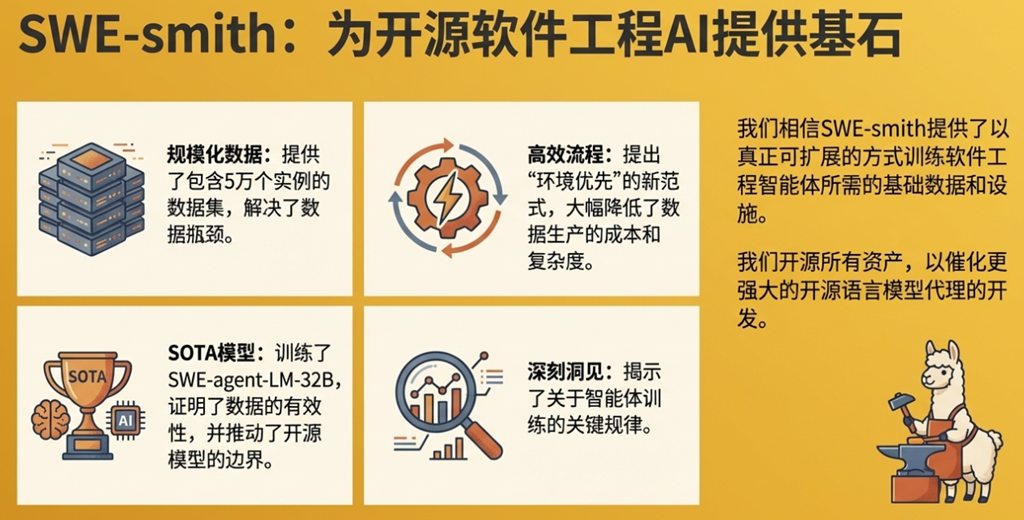
数据来源的多样性,特别是代码库的广度,对模型的泛化能力至关重要。在一项控制变量实验中,我们将训练样本的总量固定为700条专家轨迹,但改变这些轨迹的来源。
结果显示,当这700条样本来源的代码库数量从5个增加到100个时,模型的最终性能呈现出显著的对数级增长。这一发现清晰地表明,让模型接触更广泛、更多样化的代码库,有助于其学习到更通用的问题解决方法,从而提升其在未知项目上的表现。
5.3. 模型专业化潜力
SWE-smith不仅能训练通才模型,还为培养“领域专家”模型提供了可能。我们进行了一项针对性实验,以SymPy(一个流行的Python科学计算库)为例。
实验中,我们使用专门在SymPy代码库上合成的数据对模型进行微调。结果发现,经过“专业化”训练后,模型在解决SymPy相关的任务时性能显著提升(解决率从33.3%跃升至42.4%),而其在其他代码库上的通用性能仅有轻微的下降。
这一发现揭示了一条为特定项目、公司内部软件栈或特定技术领域定制高效能AI代理的可行路径。企业或开发团队可以利用SWE-smith为自己的核心代码库生成专属训练数据,从而打造出高度专业化的“AI结对程序员”。
这些发现为未来优化AI代理的训练策略、提升模型性能和拓展应用场景提供了宝贵的经验证据。接下来,我们将对SWE-smith的整体贡献进行总结,并展望其未来的发展方向。
SWE-smith是一套创新且可高度扩展的流程,它通过“环境优先,任务在后”的新范式,成功解决了开源软件工程代理面临的训练数据瓶颈。通过生成一个包含超过5万个任务实例、横跨128个真实GitHub代码库的庞大数据集,SWE-smith为领域发展提供了关键的基础设施。其直接成果——训练出的SWE-agent-LM-32B模型在权威基准测试中达到了开源模型的顶尖(SOTA)性能——无可辩驳地证明了该方法的有效性和所生成数据的卓越质量。
展望未来,SWE-smith的发展将聚焦于以下几个关键方向:
1. 跨语言扩展: 当前SWE-smith的工作流程主要以Python为中心。未来的一个核心目标是将其成熟的收集策略扩展到Java、JavaScript、C++等其他主流编程语言。这不仅是为了培养多语言能力的AI代理,更是迈向一个能够为任何主流软件生态系统生成定制化、超专业化AI代理的未来,从而深刻变革企业级软件的维护与开发模式。
2. 探索更先进的训练技术: 本文主要展示了监督式微调的应用。然而,SWE-smith生成的海量带有即时执行反馈的任务实例,为更先进的训练方法提供了理想的土壤。未来的工作将探索利用这些数据进行强化学习(Reinforcement Learning),这被视为是解锁智能体真正的自主推理与复杂问题解决能力的关键路径,使其超越简单的故障修复,迈向更高层次的软件工程任务。
SWE-smith为以真正可扩展的方式训练和发展下一代软件工程智能体提供了基础性的数据和设施。我们坚信开放合作是推动技术进步的最佳途径,因此,SWE-smith的所有资产,包括数据收集流程、任务实例、专家轨迹和训练模型,均已开源,以促进整个社区的共同进步。
如有想了解更多软件设计与架构, 系统IT,企业信息化, 团队管理 资讯,请关注我的微信订阅号:
作者:Petter Liu
出处:http://www.cnblogs.com/wintersun/
本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,否则保留追究法律责任的权利。
该文章也同时发布在我的独立博客中-Petter Liu Blog。
 关注微信