
时间:2025-05-19 14:33
人气:
作者:admin
sglang/python/sglang/srt/entrypoints/http_server.py launch_server 主要分4个步骤:
sglang/python/sglang/srt/managers/tokenizer_manager.py
get_tokenizer->AutoTokenizer.from_pretrained 从huggingface.io下载预训练好的tokenizer
词表的生成方式一般是通过统计方式取top词, 比较常见的有BPE, WordPiece, 例如BPE的训练步骤:
[UNK](未知词)、[PAD](填充)、[CLS](分类)、[SEP](分隔符)、[MASK](掩码)、语言标记(, 每个节点都有一个http_server接受请求. sglang/python/sglang/srt/entrypoints/http_server.py generate_request()->_handle_batch_request()->send_to_scheduler.send_pyobj() 把请求发给rank0的scheduler
只看了DP>1的情况.
负载均衡: node间请求是通过zmq的方式进行通信. 在node_rank=0接受原始请求(TokenizedGenerateReqInput), 也就是上面的send_to_scheduler的请求, 然后进行dispatch. 负载均衡采用round_robin/shortest_queue的方式, 其他节点接到请求后, 在handle_generate_request里把请求放到waiting_queue里面
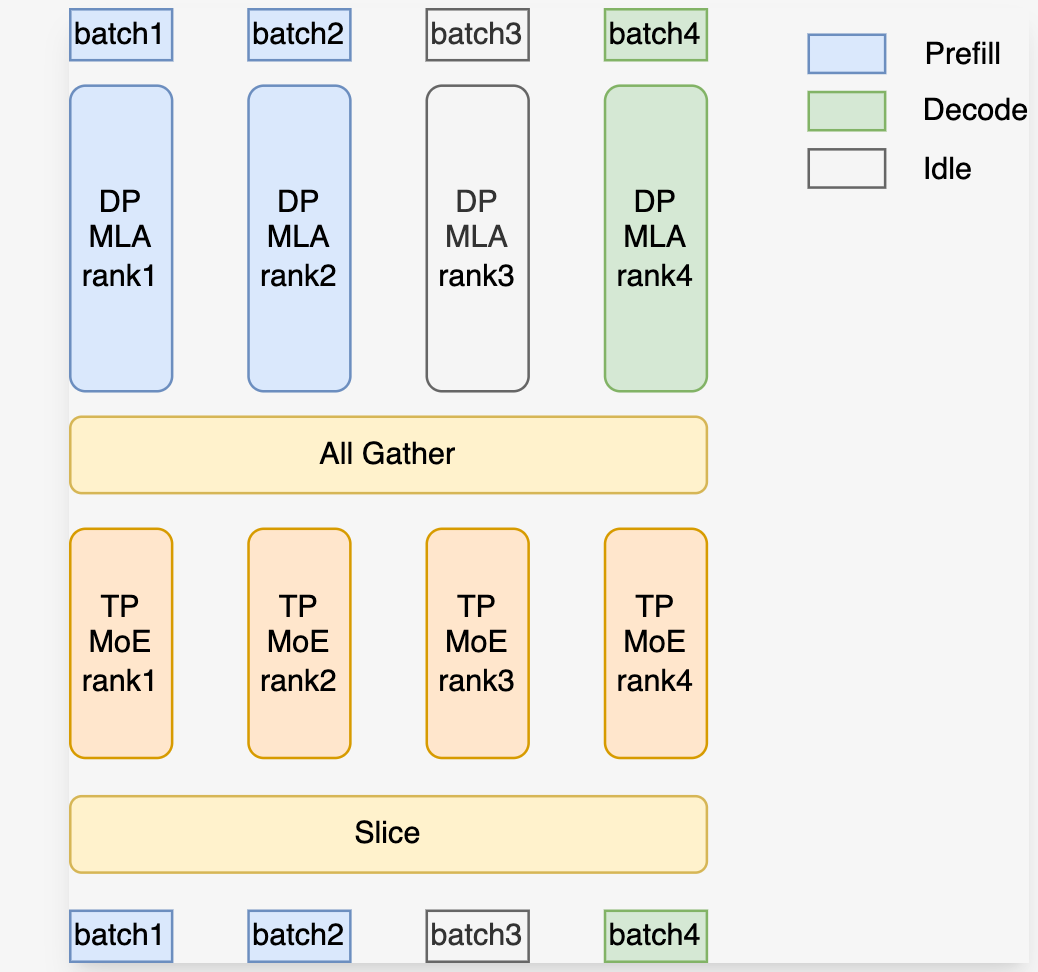
核心是launch_tensor_parallel_group这个函数, 这里根据一个开关 enable_dp_attention 进行逻辑的区分. 这个优化原理参考文档, 当模型结果中有MLA时, 如果我们在attention层使用了TP, 会导致KV结果被复制到多张卡上, 极大地浪费显存, 通过这个开关可以吧attn单独使用DP实现, 经过attn all_gather后在MOE层再进入TP逻辑. 这个函数中会计算各个device自己的PP/DP/TP rank并初始化到配置里.
完成初始化后, 根据算好的rank启动run_scheduler_process进程, 这个函数做了下面几个事:
SGLANG_SET_CPU_AFFINITY, 当启动scheduler进程的时候, 把GPU与对应范围的CPU核做黏合,也就是说,做了亲和性的线程或进程,只会在这一个CPU核上运行,只在这一个CPU核上被调度,且不会切换到其他的核上运行。开超线程(HT)的时候, bind范围需要根据逻辑核心数进行设置.
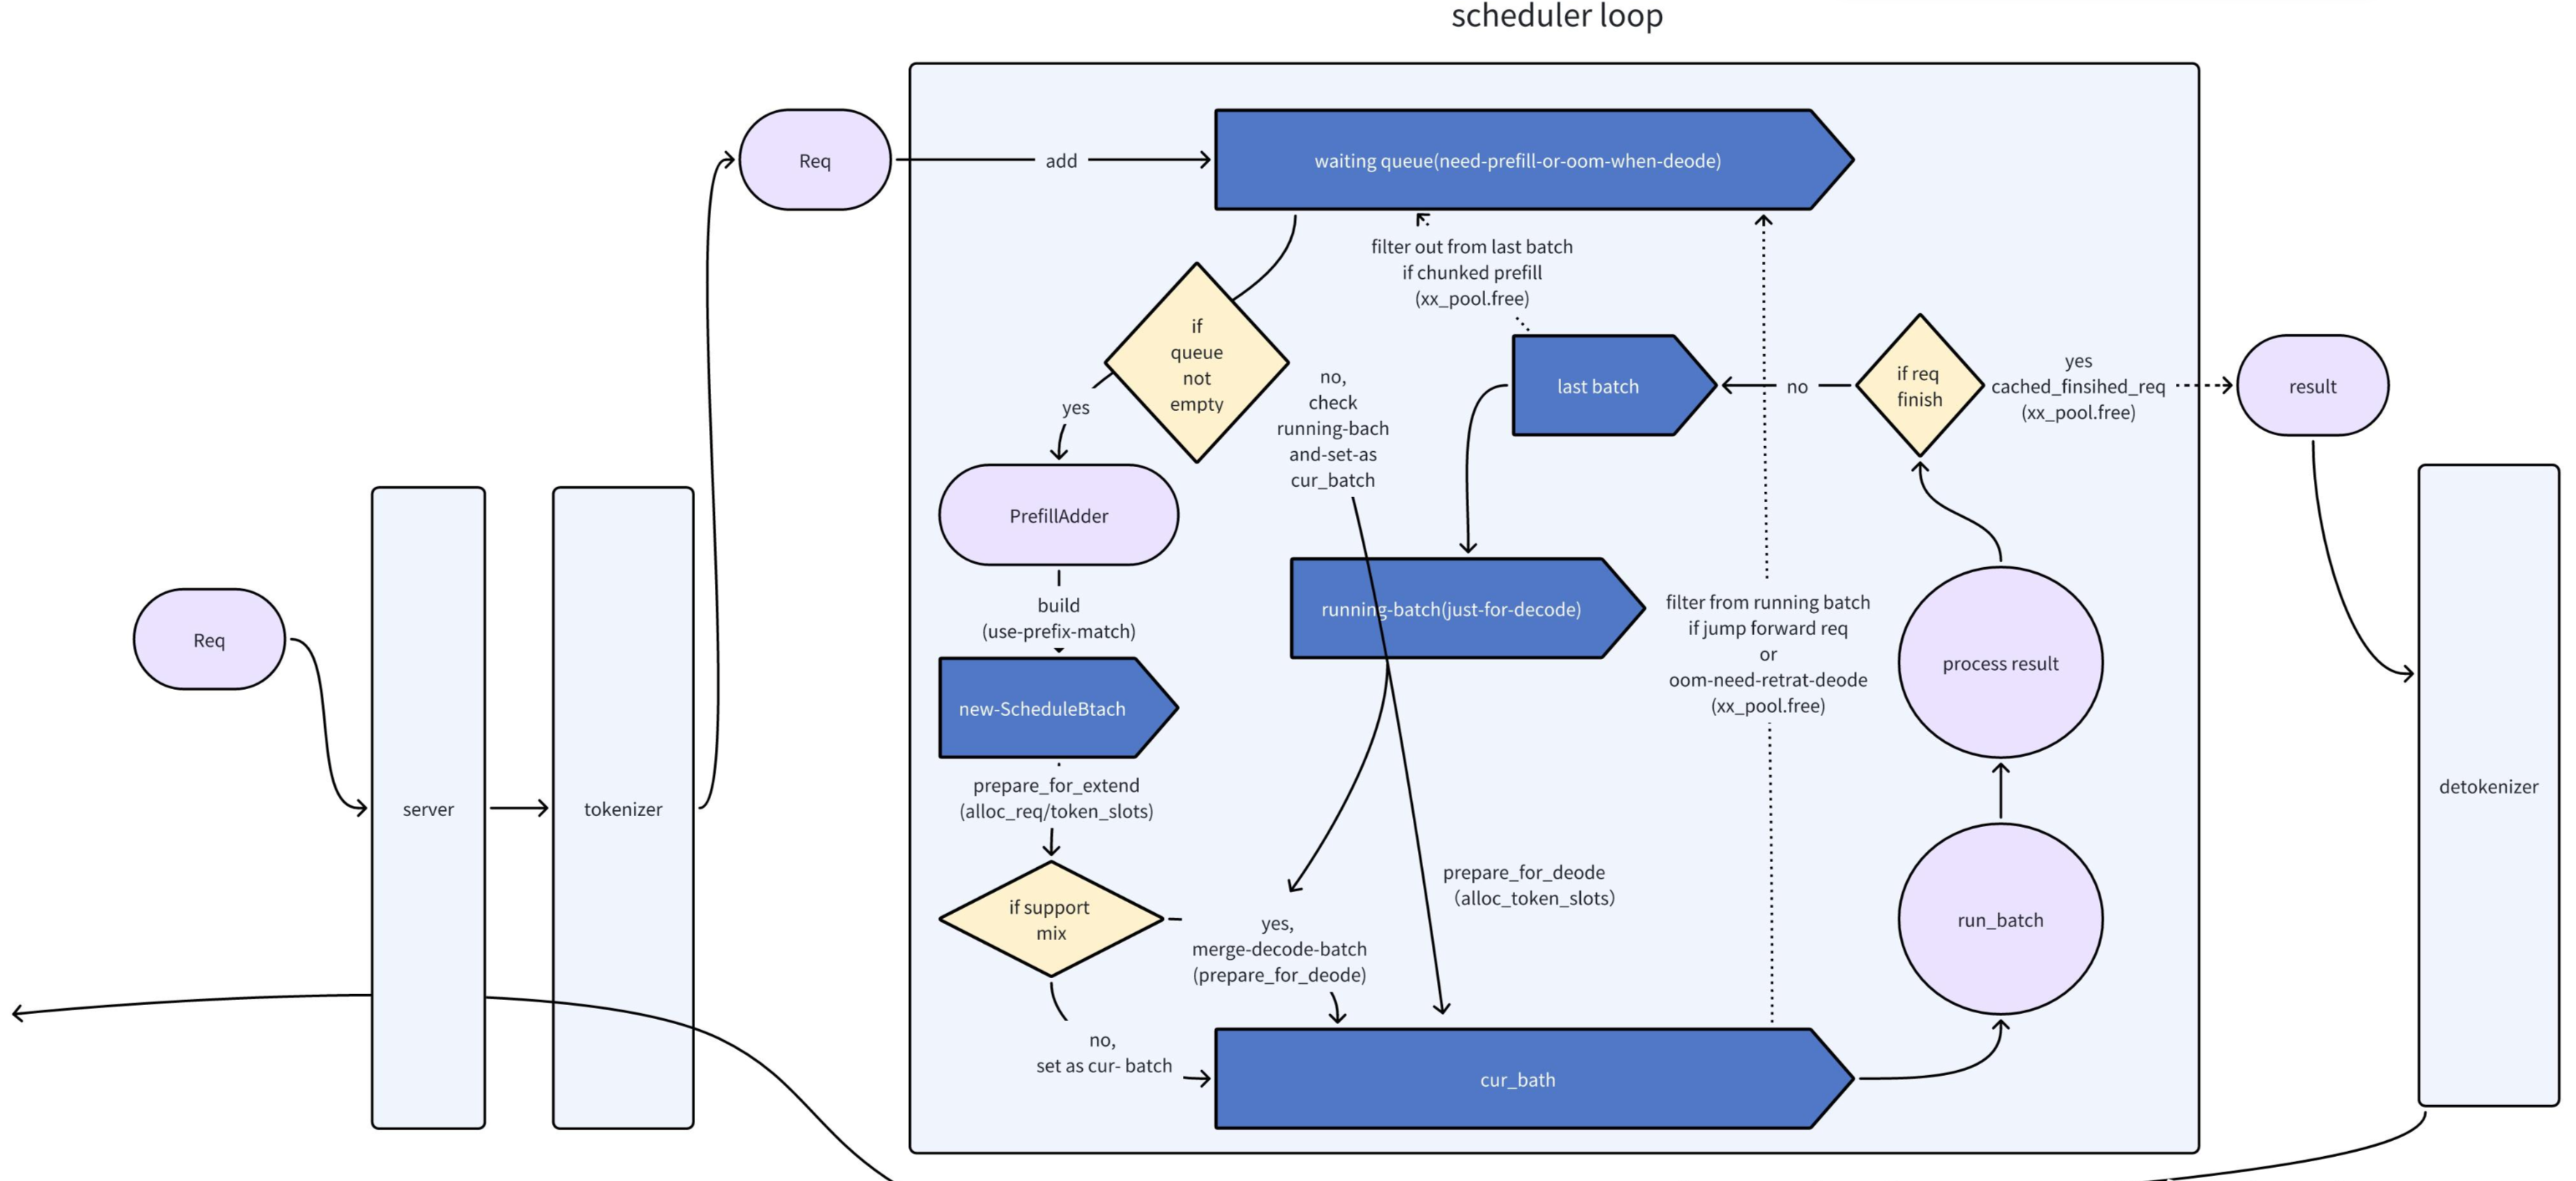
主要逻辑如图, 主要功能是把req处理成batch, 用于后续的计算backend开始forward
以event_loop_normal_disagg_prefill为基础看prefill中的逻辑. overlap省略
接受请求, 分几种并行方式来:
处理请求: TypeBasedDispatcher在这个Dispatcher内定义了每个请求类型和对应的处理方法, 心跳请求忽略
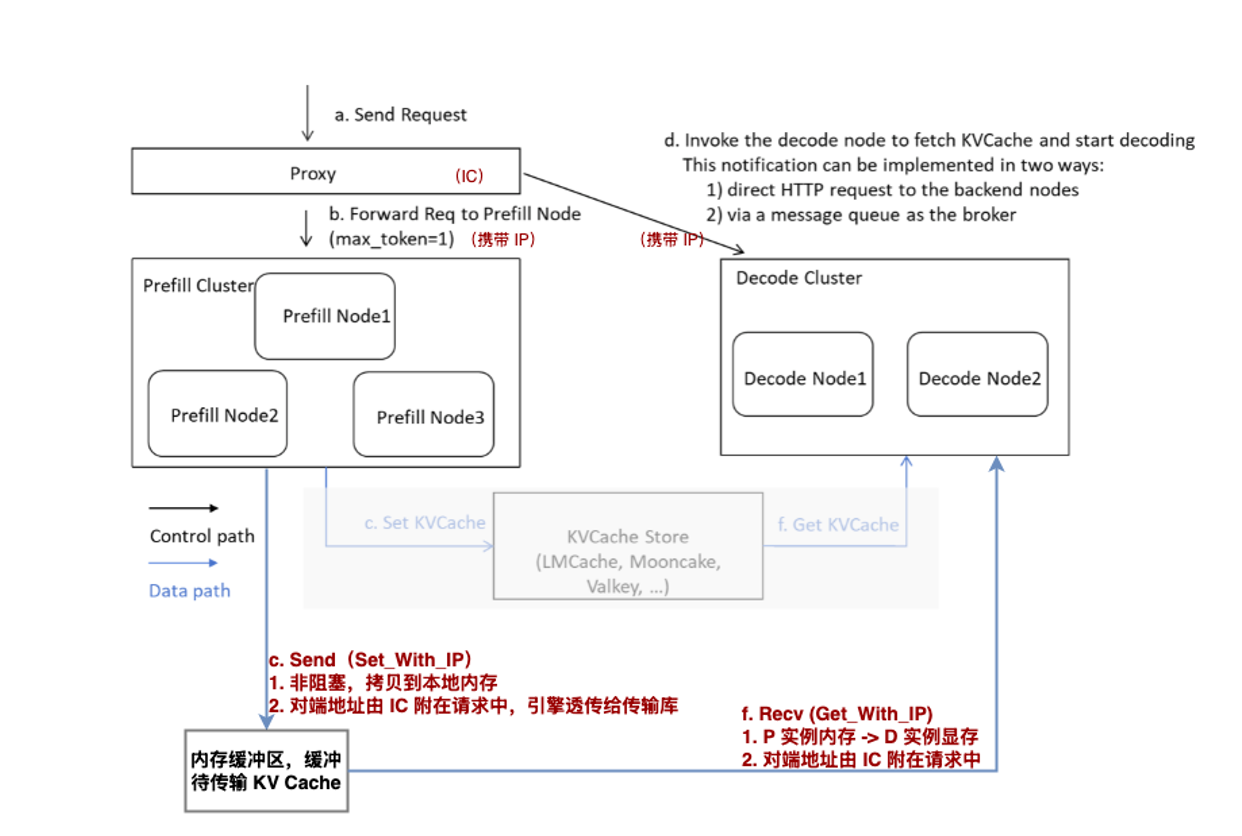
KVSender有这么几种状态: Bootstrapping(表示正在与远端节点建立连接和同步元数据), WaitingForInput(完成连接, 等待kvcache发送), Transferring(传输中)
核心函数: pop_bootstrapped, 步骤如下:
把chunked请求从batch里过滤出来, 保留chunkCache
calc_prioritypolicy策略主要分为两大类, 和tree_cache相关的和无关的. 涉及到cache命中的相关数据结构与逻辑在后文单独说.
无关的有:
有关的有:
如果存在chunked请求, 之前把它从batch里过滤出来, 在init_next_round_input根据cache中已经处理完的前缀, 确定下一个batch中要处理的chunk长度和token.
在add_chunked_req中变更ids的偏移, 并且把chunked_req加到can_run_list里
         for req in self.waiting_queue:
						#... 前面还有一些非核心逻辑,省略
            if len(adder.can_run_list) >= self.get_num_allocatable_reqs(running_bs):
                self.running_batch.batch_is_full = True
                break
            #对请求进行prefix_cache匹配, 确定在cache中的last_node, prefix_indices, 和input_len, 计算需要用多长的kvcache
            req.init_next_round_input(
                None if prefix_computed else self.tree_cache,
                self.enable_hierarchical_cache)
            #判断这个请求的token数和batch里已有的token总和是否打印max_tokens, 目标应该是防止显存超限
            #对tree_cache.last_node加锁后操作, 增加last_node的引用计数, 防止被释放.
            res = adder.add_one_req(
                req, self.chunked_req, self.enable_hierarchical_cache)
当batch满或是要处理的token数满后, 停止这个遍历循环, 然后把在can_run_list中的req从waiting_queue里剔除.
ScheduleBatch.init_new: 从can_run_list中构建ScheduleBatch类
prepare_for_extend: 为batch内的数据分配显存, 如input_ids/seq_lens 等
这个函数主要作用是统计其他DP的batch状态, 首先统计local的batch信息, 比如num_tokens, can_cuda_graph等, 通过all_gather汇聚所有DP的状态, 只要有其中一个DP存在非空的batch, 就把当前如果是空的local_batch填充一个idle_batch, 这个idle_batch的作用就是使得所有DP的运行状态保持同步, 比如其他DP有AllToAll的需求, 就可以在idle_batch中能够把对应的集合通信状态给同步运行
run_batch: forward核心逻辑, 在下一个文章中详细解读
process_batch_result_disagg_prefill: 把完成forward的prefill结果启动send_kv_cache, 并添加到disagg_prefill_inflight_queue里面
process_disagg_prefill_inflight_queue: 使用all_reduce检查所有处于kv sending状态的请求, 对已经完成发送的req交给detokenizer进行处理.
以event_loop_normal_disagg_decode为基础. 重点看下和prefill有区别的地方
recv_requests & process_input_requests, 和prefill逻辑一致
disagg_decode_prealloc_queue.pop_preallocated: Decode阶段请求进来后首先进入这个队列, 在pop时, 根据req的token数判断当前已pop出去的token总和是否大于阈值, 如果大于就暂停, 如果小于则可以对这个请求对应的kvcache分配显存, 主要目的是防止显存超限.
disagg_decode_transfer_queue.extend & pop_transferred: 把prealloc_queue pop出来的请求再填入transfer_queue, 把其中已经完成kv通信的请求挑出来, 把这些请求, 最后把这些请求加到decode模块的waiting_queue里面
decode整体是通过continus-batching的方式进行batch组合, 从而提升GPU利用率

last_batch.filter_batch(): 把上个batch里已经处理完的请求剔除.self.running_batch.merge_batch(last_batch): 把上个batch中没处理完的请求merge到running_batch里get_new_prebuilt_batch, 从waiting_queue里取出请求, 把当前batch填满到(min(self.req_to_token_pool.size, self.max_running_requests))update_running_batch((self.running_batch)): 检查batch里的请求是否有超显存的可能性, 如果有将部分请求拿出来再放回queue里(retract_decode), 分配decode tensor相关显存占用.4.run_batch & process_batch_result (同prefill)
MFU概念和计算方法:
模型实际FLOPs计算公式:
总FLOPs = 参数量 × 前向计算次数 + 2 × 参数量 × 反向计算次数(反向传播通常需要2倍前向的FLOPs)
GPU理论峰值FLOPs计算公式:
理论峰值FLOPs = GPU核心数 × 核心频率 (GHz) × 每周期运算数 × 2(“×2”表示乘加运算计为2次浮点操作)
MFU计算:
\[MFU=\frac{模型实际FLOPs}{GPU理论峰值FLOPs * 训练时间(秒)} * 100\% \]sglang阅读笔记: https://www.zhihu.com/column/c_1710767953182674944

 关注微信